
【命中】数据处理之搜索如何命中?( 三 )
隐马尔科夫模型(HMM)切词
将文字序列按照词首、词中、词尾、单字词进行标注。
举例:研究生说的确实在理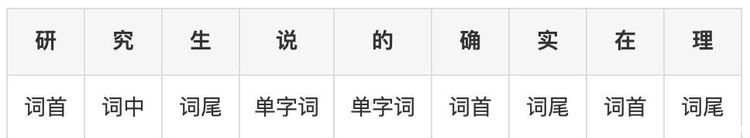
文章图片
当每个字的标注都得出的时候,切词也就顺理成章得完成了。
二、筛选
将用户输入的信息进行切分后,对引库中的内容进行匹配筛选。判定用户想要的结果是否被筛选出来,一般会从精确率(Precision)、召回率(Recall)和F1(F1-Measure)值三个维度进行衡量,这也是搜索优化中是关键性指标,涉及到人工打分和更高级的优化。
精确率:所有搜到的内容里面,相关的内容的比例。
召回率:所有应该搜到的内容里面,真正被搜出来的比例。
举例:假设此时有7个桔子和3个苹果放在一起,我想筛选出所有的桔子,系统最终筛选出了6个,其中有4个桔子。那么精确率P=4/6,召回率R=4/7。
F1值:精确值和召回率的调和均值, 也就是:
Q:为什么会有F1值的存在呢?有精确率和召回率不够吗?
A:答案是:不够!正常情况下我们是期望精确率和召回率越高越好,但这两者在某些情况下是相互矛盾的。仍以桔子苹果为例,如果系统只筛选出了1个桔子,那么精确率就是100%,召回率是1/7就会很低;如果系统一次筛选出了10个,那么召回率就是100%,精确率就只有70%。
除此之外,还有一个比较容易混淆的概念:准确率(Accuracy),即判断正确的数目与总数目的比值,其中判断正确的数目包含筛选出的符合要求的和未筛选出的不符合要求的。
仍以桔子苹果为例,准确率A=(4+1)/10=50%,即系统正确筛选出的水果(正确识别了4个桔子+正确识别了1个苹果)与总数的比值。
准确率一般不用于搜索召回的衡量,原因是若上例中苹果数量为100万个,桔子7个时,那么不管怎么筛选,准确率都是99.99%+,显然这是不符合要求的。
三、排序
排序影响着搜索的结果质量,越往前的结果越容易获得用户的点击。好的搜索不仅仅是把应该搜索的内容尽可能的搜索出来,同时还要考虑把最容易吸引用户的内容展示在前面,因此这里就涉及到两个因素:文本数据和业务数据。
3.1 文本数据
文本数据即文本的相关性分数乘以权重。关于如何计算文本的相关性,市面上已经有成熟的开源解决方案,如Lucene算法。然后根据文本类型给出相应的权重,比如系统中有标题、描述和正文三种文本,根据重要性分别赋予不同权重:标题权重为10,导语权重为5,正文权重为1。
3.2 业务数据
业务数据即数据的分数乘以权重。关于数据的分数是数据具体的值。然后根据业务类型给出相应的权重,比如系统中有评论量、分享数、阅读量三种数据,根据重要性分别赋予不同权重:评论数权重为10,分享数权重为20,阅读量权重为1。
举例:以基于Lucence的Solr系统为例,得分公式如下: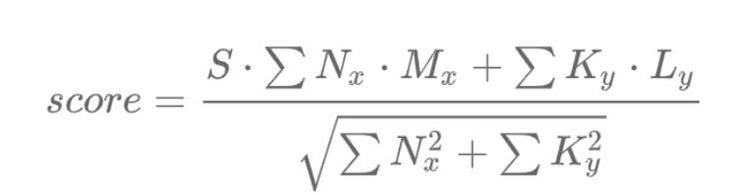
文章图片
其中Nx为文本分数权重,Mx为文本数据相关性分数,Ky为数据分数权重,Ly为数据分数。
由此可以看出,对文本数据和业务数据赋予的权重直接影响最终的排序结果,如何赋值、赋予何值需要基于对业务的理解和认知,这也是一个搜索系统设计最核心的部分。
推荐阅读





- python 爬虫,咋获得输入验证码之后的搜索结果
- 唯品会无搜索模式真的能让大众消费者驻留页面更长时间吗
- 怎样制作一个简易的信号干扰器
- 《亿万》第九集里,法官用的这个搜索引擎是啥
- 怎样评价比搞平台的自媒体比价搜索功能
- 有啥搜索引擎可以替代Google(外语)
- 高权重论坛有哪些
- 能否在网页搜索中加入点赞机制,从而个性化搜索引擎
- 原谅我辣么肤浅,搜索引擎和分类信息网真的能相提并论吗
- 普通家庭门窗智能报警器,智能门磁。搜索到的都是需要网关才可以,有单独连接wifi就可以的吗