
【命中】数据处理之搜索如何命中?( 二 )
基于词典匹配是最早的分词方法,比较典型的有:正向最大匹配法、逆向最大匹配法、双向最大匹配法。
(1)正向最大匹配法
step1:匹配时从前往后取词,取前m个字(m为词典里最长的词的字数)开始扫描;
step2:若这m个词扫描有结果,则匹配成功,将m个词切分出来,语句中剩下的词继续进行切分;
step3:若这m个词扫描无结果,则取前m-1个字继续扫描,每次减一个字,直到词典命中或剩下1个字;
step4:重复以上步骤,直至语句全部匹配完成。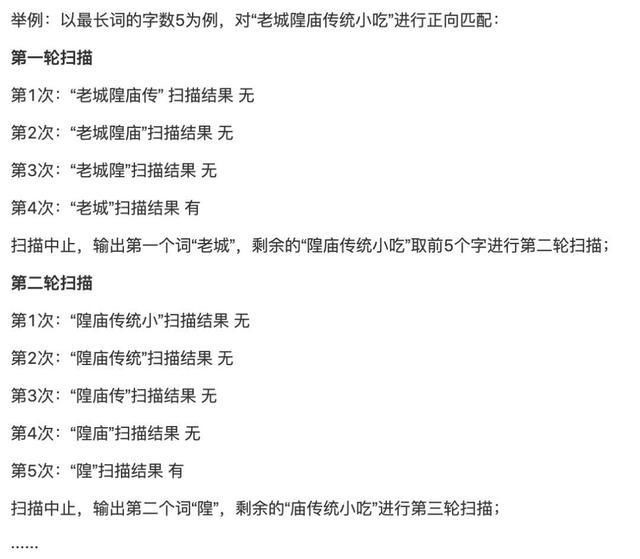
文章图片
(2)逆向最大匹配法
匹配时从后往前取词,其他逻辑和正向相同。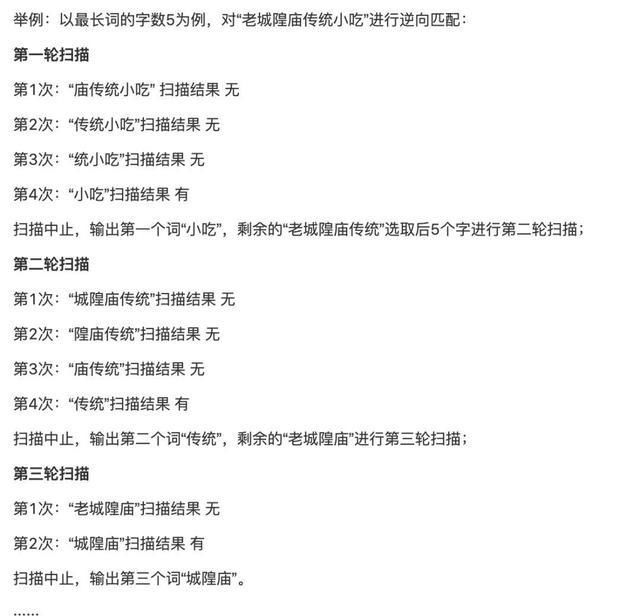
文章图片
(3)双向最大匹配法
由于正向最大匹配法和逆向最大匹配法都有其局限性,因此产生了双向最大匹配法。即按照正向和逆向分别进行切分,然后进行对比,选取其中一种分词结果输出。
对比原则:①如果正反向分词结果词数不同,则取分词数量少的那个;② 如果词数相同且结果也相同,返回任意一个,如果词数相同但结果不同,取单字数量较少的那个(单字越少越准确)。
上面提到的几种切分方法是从不同的角度来处理歧义问题,每种方法只能解决有限类别的歧义问题。随着词典的增大,词与词之间的交叉更加严重,歧义带来的负面影响也更加严重。同时,上面提到的切分方法对于新词的切分是完全无能为力的。
② 基于统计分词
基于统计分词有两类,第一类是统计取词法(或无词典分词法),把每个词看做是由字组成的,如果相连的字在不同文本中出现的次数越多,就证明这段相连的字很有可能就是一个词。
举例:比如词a出现的概率为P(a),词b出现的概率为P(b),a+b这个词组出现的概率为P(a+b),如果P(a+b)>P(a)*P(b),则能证明a+b不是一个随机出现的组合,要么是一个新词,要么是个词组或者短语。
但这种方法也有一定的局限性,会经常抽出一些共现频度高、但并不是词的常用字组,例如“这一”、“之一”、“有的”、“我的”、“许多的”等,并且对常用词的识别精度差,成本大。在实际应用中通常结合词典分词的方法使用,既发挥了词典分词切分速度快、效率高的特点,又利用了无词典分词结合上下文识别生词、自动消除歧义的优点。
另一类是基于统计机器学习的方法,在给定大量已经分词的文本的前提下,利用统计机器学习、模型学习词语切分的规律(称为训练),从而实现对未知文本的切分。这种方法的缺点就是需要有大量预先分好词的语料作支撑,而且训练的成本也很高。比较经典的是N元文法模型(N-gram)。
N元模型(N-gram)切词
基于N元模型的切词策略是:一段文本存在多种可能的切分结果(切分路径),将训练好的N-gram模型进行路径计算得到最优切分路径并返回结果。
举例:对“他说的确实在理”进行切词。
在N-gram模型的算法中,每个路径上的边都是一个N-gram的概率,于是得到如下概率路径有向图: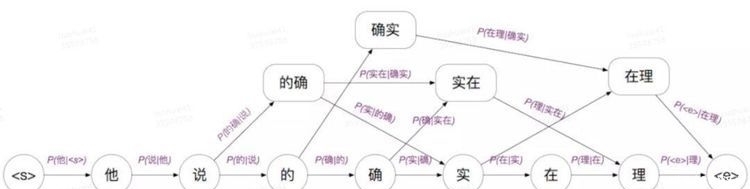
文章图片
可能的切分路径有:他说/的确/实在/理 、他说的/确实/在理、 他说的/确/实在/理、 他/说/的确/实在/理、 他/说的/确/实在/理……
假设随机变量S为一个汉字序列,W是S上所有可能的切分路径(如上图所有从头至尾的不同路径)。对于分词,实际上就是求解使条件概率P(W∣S)最大的切分路径W*,P(W∣S)即为每条路径的衡量标准。
至此,分词任务就转变成了一个数学问题。
③ 基于序列标注分词
基于序列标注分词是把分词过程视为字在字串中的标注问题(例如将字标注为“首字中间字尾字”或者其他标注方式),当这些标注完成的时候切词也就自然完成了。这种策略能够平衡地看待字典词和新词(未收录到词典的词)的识别问题,大大简化了使用门槛,并得到一个相当不错的切词结果。如条件随机场(CRF)、隐马尔科夫模型(HMM)、最大熵算法、神经网络分词模型等。
推荐阅读



- python 爬虫,咋获得输入验证码之后的搜索结果
- 唯品会无搜索模式真的能让大众消费者驻留页面更长时间吗
- 怎样制作一个简易的信号干扰器
- 《亿万》第九集里,法官用的这个搜索引擎是啥
- 怎样评价比搞平台的自媒体比价搜索功能
- 有啥搜索引擎可以替代Google(外语)
- 高权重论坛有哪些
- 能否在网页搜索中加入点赞机制,从而个性化搜索引擎
- 原谅我辣么肤浅,搜索引擎和分类信息网真的能相提并论吗
- 普通家庭门窗智能报警器,智能门磁。搜索到的都是需要网关才可以,有单独连接wifi就可以的吗