
Eigen的速度为啥这么快( 四 )
注意开头两个宏指令。如果不清楚详见Eigen的说明文档:
Eigen的Intel MKL说明:
http://eigen.tuxfamily.org/dox-3.2/TopicUsingIntelMKL.html
对MKL的g++的编译链接参数可以参考Intel的指导网页:
Intel? Math Kernel Library Link Line Advisor
https://software.intel.com/en-us/articles/intel-mkl-link-line-advisor/
按照Intel Link Advisor的配置进行编译链接,这里选择了静态链接,以便发布到其他机器上测试运行。
g++ -std=c++11 -O3 -fopenmp main.cpp -DMKL_ILP64 -m64 -I/opt/intel/mkl/include -I/home/eric/local_install/eigen-337 -Wl,--start-group /opt/intel/mkl/lib/intel64/libmkl_intel_ilp64.a /opt/intel/mkl/lib/intel64/libmkl_gnu_thread.a /opt/intel/mkl/lib/intel64/libmkl_core.a -Wl,--end-group -lgomp -lpthread -lm -ldl -o main
在三台物理机上的测试结果: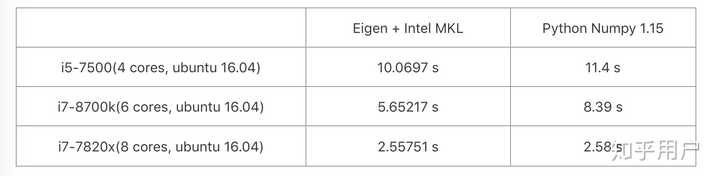
值得注意的是,如果你的环境没有安装MKL或其他blas库,那么请至少记得开启你的gcc优化选项-O2 -O3 和openmp多线程支持-fopenmp。
如果不开启gcc优化, 单纯开启-fopenmp, 我在本地机器下同样的1w*1w的matrix dot product, 5分钟都没有结果。开启-O3优化后, 58秒出结果。所以可见gcc的编译优化对于Eigen还是很重要的。
■网友
Armadillo+Openblas的组合比Eigen要快很多
■网友
eigen最好的地方不应该是head-only 可以直接扔到cuda里面骚操作嘛?
其他啥matlab做得到嘛~几乎无痛切换到cuda的诱惑比写simd啊avx啊高的不知道哪里去了
(然而windows下eigen 在cuda下面各种报错,我已经看腻了bug fix了)
■网友
通过并行指令集将算法并行化,比如矢量运算,底层合理并行,速度就快了几倍。一言以蔽之,结合硬件的编程技巧
■网友
【Eigen的速度为啥这么快】 为啥在我这里两个1000阶双精度随机数矩阵相乘,numpy耗时肉眼不可察觉,而Eigen花费大概4秒以上?
■网友
模板,模板元--------------------------------------------------------我是都没用过,闭眼答得、、还有,动态多态(继承,虚函数)只会降低执行速度的、、
推荐阅读







- 市行政■盐城不动产交易一体化平台跑出全省最快加速度
- 南北■长三角加速度!打通江苏南北的“高铁生活”倍受期待
- 互联网怎样解决“家政服务上门速度慢”的问题
- 为啥看到书柜上的藏书会有心旷神怡的感觉
- 为啥知乎上普便有一种【我在北上广深打工,所以拥有更好的视野】这样的错觉
- 为啥工商银行的用户体验如此之差
- 汽车|看了中消协4S店服务测评调查结果,终于知道法系车为啥卖不好了
- 你为啥从窝窝商城离职?
- 为啥5G和2.4G默认的BSSID是相同的
- 为啥电器实体店的价格比淘宝贵那么多