
Eigen的速度为啥这么快( 二 )
■网友
以前也觉得 Eigen 很快,感觉和 mkl 可以媲美。但是昨天 debug 时一行一行看时间,发现这样一个矩阵乘法
要算将近一秒(
),而同样的计算用 MATLAB 只需要肉眼不可察觉的时间。我 google 了一下,在 StackOverflow 上(How to speed up Eigen library\u0026#39;s matrix product?)有人讨论说是 MATLAB 内部自动会调用多线程版的 mkl 里的矩阵乘法,而 Eigen 在通常状态下是单线程的,需要在编译时加上
参数使用 openmp 开启多线程。我在自己的 Mac 上尝试了一下,在线程数为 4 的情况下,时间缩短为 0.57 秒,但相比 MATLAB 的肉眼不可察觉还是有差距。我对计算机底层的硬件不是很熟,只是最近突然觉得处理起这种可以高度矢量化的问题时,(不是非常 wisely 地)使用Eigen 还是没有经过优化的 MATLAB 快。P.S.: 最开始的单线程版本我使用的是 OS X 自带的
编译器,优化参数为
. 测试过加上
没有明显区别。这个
实际上是Apple 封装后的
,很可惜的是不支持 openmp. 所以为了开启多线程我安装了 GNU
编译器。其它编译参数不变。=================更新==================刚才又上 StackOverflow 上看了别人的几个帖子(Eigen vs Matlab: parallelized Matrix-Multiplication)学习了一下,发现了几个新的 trick:首先之前线程数我设置错误了。我的 CPU physically 应该只有两个核,四线程是 hyper-thread 的结果,多出来的两个线程并不能加速。我把 OMP_NUM_THREADS 改为 2 以后,速度变为 0.55s 左右;如果计算矩阵乘法,使用
是个不错的 trick,它可以避免生成 temporary 的矩阵存储中间结果。使用这个后缩短为 0.50s 左右;对 Eigen 3.3 或以上的版本可以加上
和
两个参数,进一步缩短为 0.40s 左右。这样总的下来提速了约 30%.=============================经评论区提醒 Ofast 进行了一些 unsafe 的数学优化所以可能牺牲精度,在极端情况下甚至出错。参考如下 stackoverflow 链接的讨论:https://stackoverflow.com/questions/14492436/g-optimization-beyond-o3-ofast
■网友
感兴趣的朋友可以看一下这个pdf,是eigen的主要开发者对其功能和优化进行的总结:
eigen_CGLibs_Giugno_Pisa_2013.pdf这里也根据这个pdf简单说两句。
Eigen的优化主要可以看这个结构图: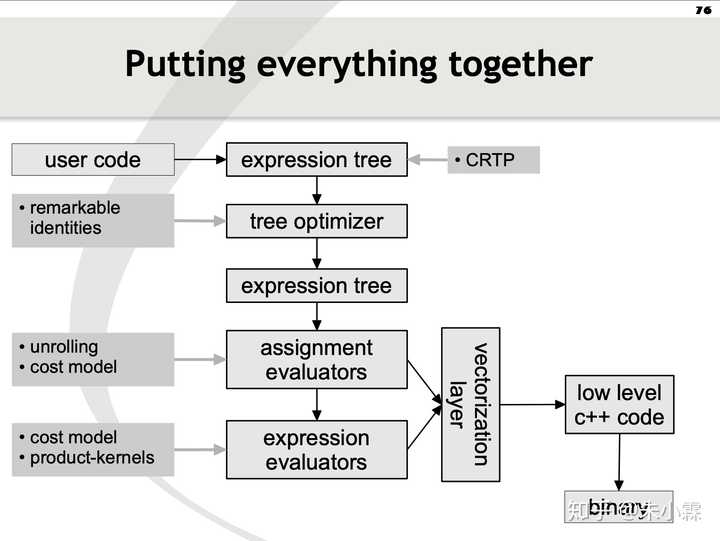

推荐阅读







- 市行政■盐城不动产交易一体化平台跑出全省最快加速度
- 南北■长三角加速度!打通江苏南北的“高铁生活”倍受期待
- 互联网怎样解决“家政服务上门速度慢”的问题
- 为啥看到书柜上的藏书会有心旷神怡的感觉
- 为啥知乎上普便有一种【我在北上广深打工,所以拥有更好的视野】这样的错觉
- 为啥工商银行的用户体验如此之差
- 汽车|看了中消协4S店服务测评调查结果,终于知道法系车为啥卖不好了
- 你为啥从窝窝商城离职?
- 为啥5G和2.4G默认的BSSID是相同的
- 为啥电器实体店的价格比淘宝贵那么多