
|面试官:说一下HashMap原理,为什么会产生死循环
文章图片
文章图片
文章图片
文章图片
文章图片
文章图片
文章图片
文章图片
Map 这样的 Key Value 在软件开发中是非常经典的结构 , 常用于在内存中存放数据 。 众所周知 HashMap 底层是基于 数组 + 链表 组成的 , 不过在 JDK1.7 和 1.8 中具体实现稍有不同 。
今天我们只讲解JDK1.7版本的HashMap 。
1、HashMap的数据结构图是一个数组+链表结构
2、HashMap成员变量
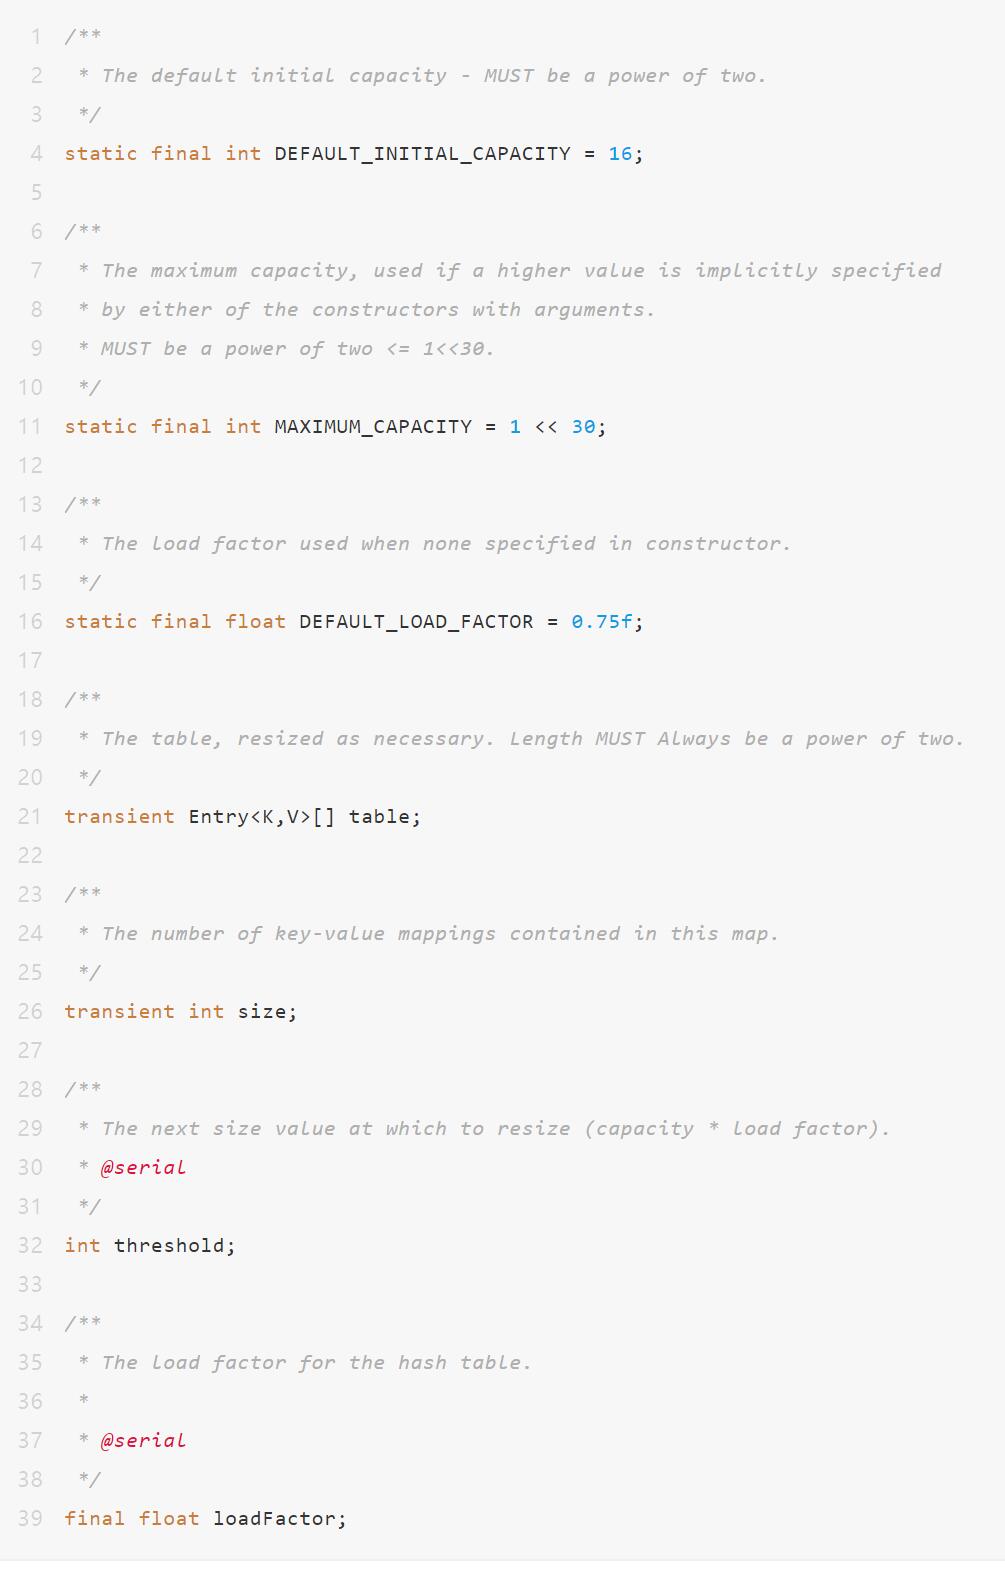
这是 HashMap 中比较核心的几个成员变量;看看分别是什么意思?
① DEFAULT_INITIAL_CAPACITY :初始化桶大小(16) , 因为底层是数组 , 所以这是数组默认的大小 。
② MAXIMUM_CAPACITY :桶最大值 。
③ DEFAULT_LOAD_FACTOR :默认的负载因子(0.75)
④ table:真正存放数据的数组 。
⑤ size:map中存放的键值对的数量 。
⑥ threshold:resize扩容时的阈值 。
⑦ loadFactor:负载因子 , 可在初始化时显式指定 。
HashMap 的构造函数可以指定参数也可以无参:
默认容量为 16 , 负载因子为 0.75 。 Map 在使用过程中不断的往里面存放数据 , 当数量达到了 16 * 0.75 = 12 就需要将当前 16 的容量进行扩容 , 而扩容这个过程涉及到 rehash、复制数据等操作 , 所以非常消耗性能 。
因此通常建议能提前预估 HashMap 的大小最好 , 尽量的减少扩容带来的性能损耗 。
3、Entry类根据代码可以看到真正存放数据的是:transient Entry<KV>[
table , 这个数组 , 那么它又是如何定义的呢?
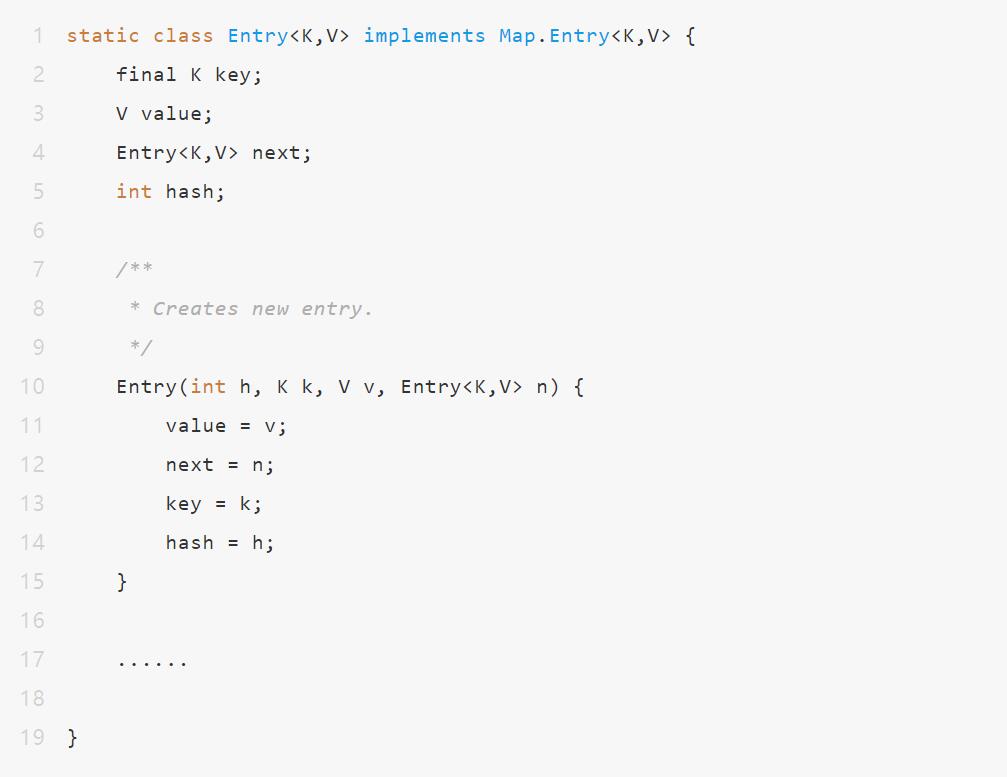
Entry 是 HashMap 中的一个内部类 , 从它的成员变量很容易看出:
① key 就是写入时的键 。
② value 自然就是值 。
③ 开始的时候就提到 HashMap 是由数组和链表组成 , 所以这个 next 就是用于实现链表结构 。
④ hash 存放的是当前 key 的 hashcode 。
知晓了基本结构 , 那来看看其中重要的put、get方法 。
4、put 方法
① 如果 key 为空 , 则 put 一个空值进去 。
② 根据 key 计算出 hashcode 。
③ 根据计算出的 hashcode 定位出所在桶 。
④ 如果桶是一个链表则需要遍历判断里面的 hashcode、key 是否和传入 key 相等 , 如果相等则进行覆盖 , 并返回原来的值 。
⑤ 如果桶是空的 , 说明当前位置没有数据存入;新增一个 Entry 对象写入当前位置 。
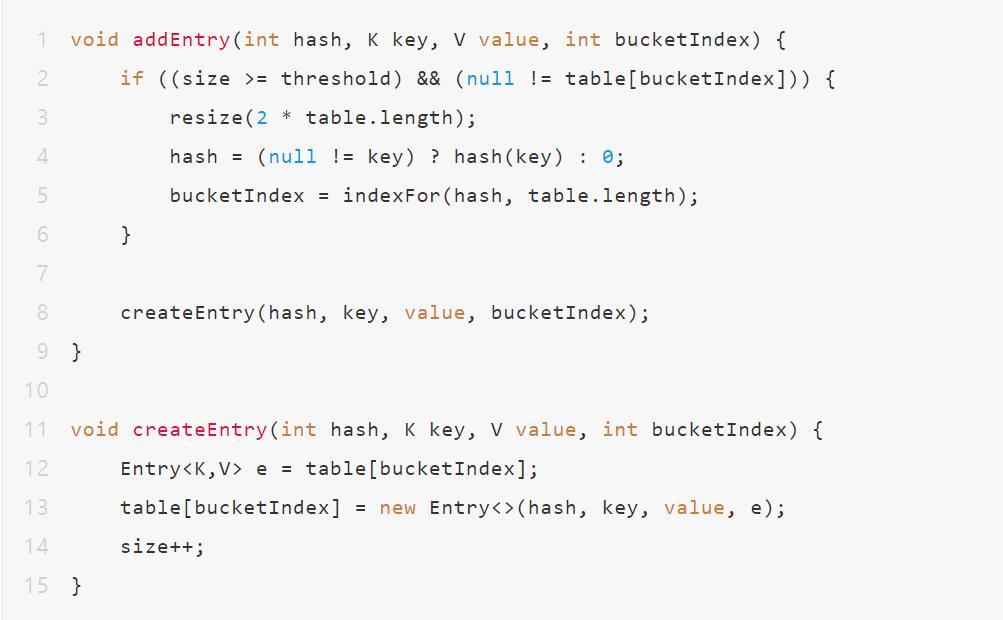
① 当调用 addEntry 写入 Entry 时需要判断是否需要扩容 。
② 如果需要就进行两倍扩充 , 并将当前的 key 重新 hash 并定位 。
③ 而在 createEntry 中会将当前位置的桶传入到新建的桶中 , 如果当前桶有值就会在该位置形成链表 。 新new的Entry会加到链表的头部 。
5、get 方法
① 首先也是根据 key 计算出 hashcode , 然后定位到具体的桶中 。
② 判断该位置是否为链表 。
③ 不是链表就根据 key、key 的 hashcode 是否相等来返回值 。
④ 为链表则需要遍历直到 key 及 hashcode 相等时候就返回值 。
⑤ 啥都没取到就直接返回 null。
6、并发场景下出现死循环多线程同时put时 , 如果同时调用了resize操作 , 可能会导致循环链表产生 , 进而使得后面get的时候 , 会死循环 。 下面详细阐述循环链表如何形成的 。
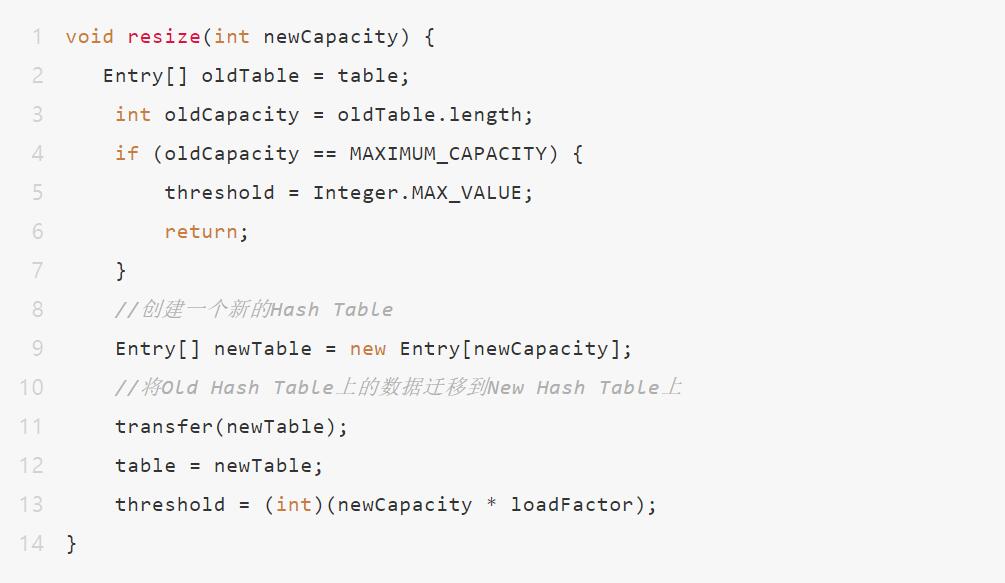
resize函数
数组扩容函数 , 主要的功能就是创建扩容后的新数组 , 并且将调用transfer函数将旧数组中的元素迁移到新的数组 。
transfer函数
transfer逻辑其实也简单 , 遍历旧数组 , 将旧数组元素通过头插法的方式 , 迁移到新数组的对应位置问题出就出在头插法 。
下面举个实际例子:
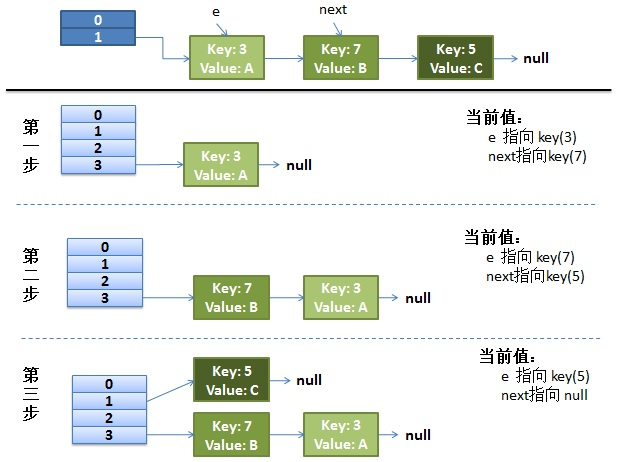
【|面试官:说一下HashMap原理,为什么会产生死循环】① 我假设了我们的hash算法就是简单的用key mod 一下表的大小(也就是数组的长度) 。
② 最上面的是old hash 表 , 其中的Hash表的size=2 加载阈值为2?0.75=1 , 所以key = 3 7 5 , 在mod 2以后都冲突在table[1
这里了 。
③ 接下来的三个步骤是Hash表 resize成4 , 然后所有的<keyvalue> 重新rehash的过程
正常的Rehash的过程:
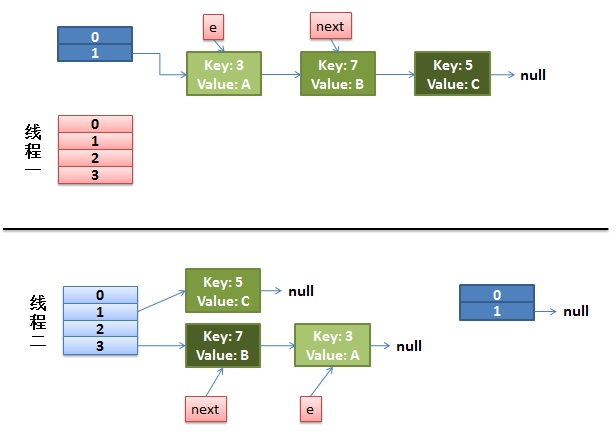
并发下的Rehash过程:
1)假设我们有两个线程 , 用红色和浅蓝色标注了一下 。
我们再回头看一下transfer代码中的这个细节:
而我们的线程二执行完成了 。 于是我们有下面的这个样子 。
注意 , 因为Thread1的 e 指向了key(3) , 而next指向了key(7) , 其在线程二rehash后 , 指向了线程二重组后的链表 。 我们可以看到链表的顺序被反转了 。
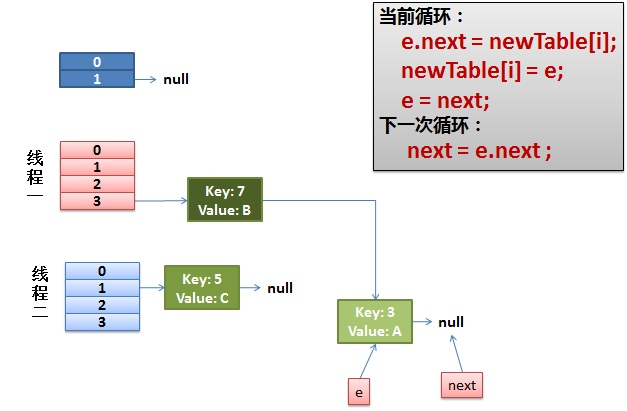
2)线程一被调度回来执行
先是执行 newTalbe[i
= e;然后是e = next , 导致了e指向了key(7) , 而下一次循环的next = e.next导致了next指向了key(3)
3)一切安好
线程一接着工作 。 把key(7)摘下来 , 放到newTable[i
的第一个 , 然后把e和next往下移 。
4)环形链表出现
e.next = newTable[i
导致 key(3).next 指向了 key(7)
注意:此时的key(7).next 已经指向了key(3) ,环形链表就这样出现了 。
于是 , 当我们的线程一调用到 , HashTable.get(11)时 , 悲剧就出现了Infinite Loop 。
有人把这个问题报给了Sun , 不过Sun不认为这是一个问题 。 因为HashMap本来就不支持并发 , 要并发就用ConcurrentHashmap 。
这个循环链表问题只存在于JDK1.7中 , 在JDK1.8中使用了不同的扩容实现方式 , 所以不会出现这种情况 。 JDK1.8中HashMap是如何实现的我们后续讲解 。
欢迎小伙伴们留言交流~~
推荐阅读




- 这款蛋黄肉松面包,柔软又香甜,吃过的人都说好!
- 三星堆遗址|三星堆“迁都”猜想|自然灾害说:洪水、地震等致三星堆古城毁亡
- 钱学森|钱学森侄子,拿下诺奖后为何说:我不是中国人,我在美国长大
- 我家午餐,3个家常菜,朋友说伙食太好了,想来家蹭饭
- 冠心病|冠心病心肌缺血不宜干什么活?能干什么活?心脏医生说的清清楚楚
- 减肥|较真丨减肥产品含违禁药再被曝光,为什么说滥用这些产品是在玩命?
- 饭店大厨说漏嘴的秘密,红油干拌饺子这样做才好吃
- 疫苗|你还在犹豫要不要接种新冠疫苗?看看科学分析怎么说
- 甲状腺|如果你的脖子有3种异常,就说明甲状腺“病变”严重
- 柳州|泪别天使宝宝!柳州1岁大婴儿捐器官救2人