
Hierarchical Softmax为啥可以保证语料库里的词可以嵌入到一个低维的向量空间
hierarchical softmax是一种对普通的softmax的优化技术。softmax的目的是为了计算概率
,即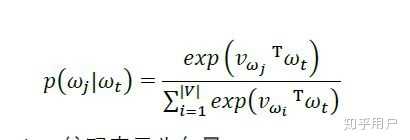
【Hierarchical Softmax为啥可以保证语料库里的词可以嵌入到一个低维的向量空间】 而hierarchical softmax则是换了一种方式。它的思想是对单词集合不断做二分类直至每个分类中都只含有一个单词,显然这种分类的过程可以被描述成二叉树的结构。也就是说hierarchical softmax仅仅是改变了概率的计算方式而已,在其它地方和使用传统softmax的模型是没有区别的,当然了随机梯度下降时的公式也会不一样。
至于词向量在哪里,word2vec的神经网络输出的本来就是词典中的单词在某一个单词附近出现的概率,也就是说它的输出不是我们所需要的。我们要的词向量是神经网络中的参数,也就是上图中的
。
如果你想理解hierarchical softmax,请去看。word2vec的论文都是直接拿来用的,不会告诉你为什么可以这样用,或者你可以直接看下面我自己写的文档。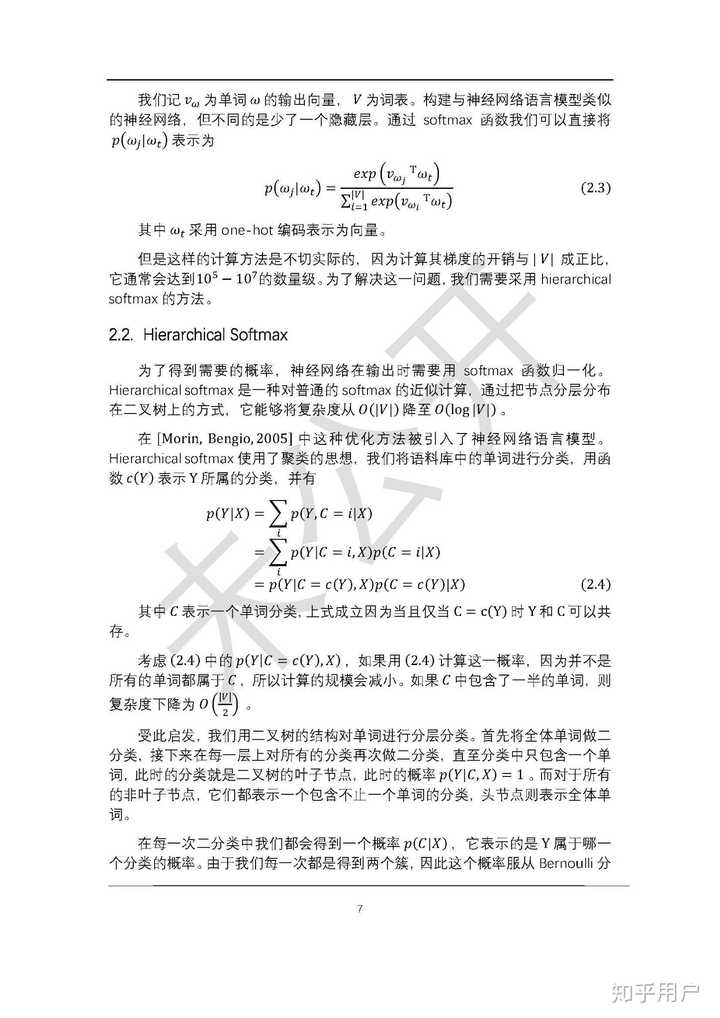

顺在一提,因为gpu加速而导致的算力突飞猛进,现在hierarchical softmax某种意义上说已经是一种不常用的trick了,当然了解总没有坏处。
■网友
我个人觉得HS除了解决计算的问题,在选择负样本上也隐含了要选择和正样本热门程度差不多的负样本的思想。
■网友
HS只是用来解决直接优化softmax loss复杂度太高的问题的一种方法,也有其他的loss或者求解方法作为替代。词嵌入是neural language model做的事情,用不用HS取决于最上层是不是用了softmax以及是否用它来求解。
■网友
我理解的hierarchical softmax是word2vec里的,如果已知context去求word的概率p直接用softmax的话,需要计算所有词与context的内积,运算量是很大的。反之,如果构建一个huffman tree,每次进行一次二分,那么求p的话只需要沿着路径从根节点到指向这个词word的叶子节点,把一路上的概率相乘即可,运算量上小了许多。所以我感觉只是一种减少运算量的方法。不足之处希望指出:)参考:http://www.tuicool.com/articles/fmuyamfhttp://www.tuicool.com/articles/7jQbQvr
■网友
占坑) 可以去看一下Bengio2005年的那篇hs的文章,【Hierarchical Probabilistic Neural Network Language Model】输入的是单词表达,hs的输出可以理解为中间结点的表达,中间节点是每一次分类,可以看作多分类问题。
■网友
Huffman Tree 的主要想法是减少了输出层的计算量的一个技巧,跟嵌入关系不大,根据具体学习任务决定使用什么技巧。没有HT也可以嵌入,比如用negative sampling。但是Negative sampling没办法得到字典集所有词的概率。
Huffman Tree 又叫 Huffman Coding,基于词频的分布来构建一个二叉树,可以证明这是最有效率的一种编码方式(建树的过程就是通过词频对词表的编码过程)。越是出现得多,编码越短,越接近根节点,这样在搜索的时候能够很快找到,也就是论文中的L(w)较小。比较有趣的是,这里用于取代softmax的是sigmoid的乘积,完美的对应了概率的二分。


推荐阅读







- 为啥看到书柜上的藏书会有心旷神怡的感觉
- 为啥知乎上普便有一种【我在北上广深打工,所以拥有更好的视野】这样的错觉
- 为啥工商银行的用户体验如此之差
- 汽车|看了中消协4S店服务测评调查结果,终于知道法系车为啥卖不好了
- 你为啥从窝窝商城离职?
- 为啥5G和2.4G默认的BSSID是相同的
- 为啥电器实体店的价格比淘宝贵那么多
- 现在在线学习视频有很多了,为啥大部分人还是喜欢下载下来观看
- 为啥到现在你还没有女朋友 ?
- 天赐的声音|33岁张雨绮为啥总离婚?看过这些照片就明白了,都是性感惹得祸