
为啥在PR曲线里面查全率为1,查准率为0查准率为1时,查全率为0啥情况会出现查全为1查准为0
谢邀,尽信书不如无书。书里的这张图误导人了。
按照周老师的书的定义,我们知道查准率P和查全率R的定义为:
如果我们现在手头有100个西瓜,其中有50个好瓜,如果我们预测这100个全是好瓜,那么,我们按照定义,此时:
但是50/50=1
也就是说查全率为1的时候,查准率不一定是0。
■网友
precision在particle physics叫做purity,recall叫做efficiency。虽然PR curve不总是一个是0另一个就是1,也不总是单调。但是大致上是负相关的。
用下图来帮助理解precision和recall:一个binary classification的预测分布,x轴代表classifier预测的probability,y轴代表预测结果的概率密度。
红色是真实的0,蓝色是真实的1。在分析数据的时候,选一个x值当做x_cut(比如0,下图竖线),x\u0026gt;0就算做1 ,x\u0026lt;0就算0。也就是说下图右边都预测1,左边都预测0。
【为啥在PR曲线里面查全率为1,查准率为0查准率为1时,查全率为0啥情况会出现查全为1查准为0】 Precision就是(右边蓝色面积)/(右边蓝色面积+右边红色面积);recall就是(右边蓝色面积)/(右边蓝色面积+左边蓝色面积)。
想要增加precision,就是要提高模型预测1的精确度,要减少false positive,减少竖线右边红色面积,所以要把x_cut的竖线向右移。当你把x_cut移到最右边,precision=~1,recall=~0。直观的理解就是,你只把你很确定是1的数据叫做1,那么就(1)很少会有实际是0的数据被不小心分类成了1,(2)很多实际是1的被你扔了,分类成0了(false negative is large)。
同理,想要增加recall,就是要提高模型找出所有1的效率,要增加竖线右边蓝色面积,所以要把x_cut的竖线向左移。当你把x_cut移到最左边,precision=~0,recall=~1。直观的理解就是,你把所有真实是1的数据都叫做1,那么就你同时把很多实际是0的算进来了,也分类成1了(false postive is large)。
具体的数值跟蓝色和红色的分布有关。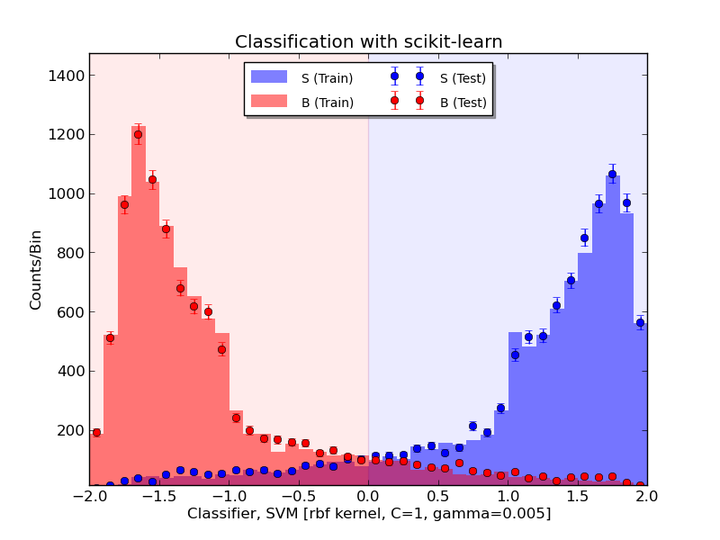
■网友
正好这两天复习期中考,还知道怎么回答这个问题,来一波首答。
首先上结论,查准率(precision)= 1时,查全率(recall)≠ 0;同样地,查全率(recall)≠ 1时,查准率(precision)≠ 0。
下面进行解释:
针对二分类问题我们有了一个学习器 f(.)(本问题中就是个分类器),对于每个样本 Xi 都有一个预测值 f(Xi) 用于描述 Xi 可能是正例的置信度,记每个样本的真实分类为 Yi,i=1,2,...,n。于是我们有n个三元组(Xi, Yi, f(Xi)),i=1,2,...,n。现在我们不妨假设 f(X1) \u0026gt; f(X2) \u0026gt; ... \u0026gt; f(Xn),即分类器做出判断 X1 最可能是正例,其次是 X2,...,最后是 Xn 最不可能是正例。
(这里 n 为样本量,f(Xi) ∈ R)
毕竟预测值只是数字,没告诉我们到底预测结果是什么类。所以我们需要一个规则:设定一个值 M,当 f(Xi) ≥ M 时认为 Xi 是正例,否则是反例。
对于这 n 个样本的分类器预测结果,显然只需要考虑 M := f(X1),..., M := f(Xn) 这n种情况。当M := f(X1) 时,根据规则,只有 X1 被分类器认为是正例。当M := f(X2) 时,根据规则,只有 X1 和 X2 被分类器认为是正例。 当 M := f(Xn) 时,根据规则,X1, ..., Xn 都被分类器认为是正例。

推荐阅读





- 为啥看到书柜上的藏书会有心旷神怡的感觉
- 为啥知乎上普便有一种【我在北上广深打工,所以拥有更好的视野】这样的错觉
- 为啥工商银行的用户体验如此之差
- 汽车|看了中消协4S店服务测评调查结果,终于知道法系车为啥卖不好了
- 你为啥从窝窝商城离职?
- 为啥5G和2.4G默认的BSSID是相同的
- 为啥电器实体店的价格比淘宝贵那么多
- 现在在线学习视频有很多了,为啥大部分人还是喜欢下载下来观看
- 为啥到现在你还没有女朋友 ?
- 天赐的声音|33岁张雨绮为啥总离婚?看过这些照片就明白了,都是性感惹得祸